大脑早就写好了答案:为什么 AI 一定是「通用大模型 + 垂域小模型 + 调度 Agent」
一份关于神经科学事实核查、产业架构收敛与商业 / 哲学后果的深度分析。观察者视角 · 2026 年 9 月。
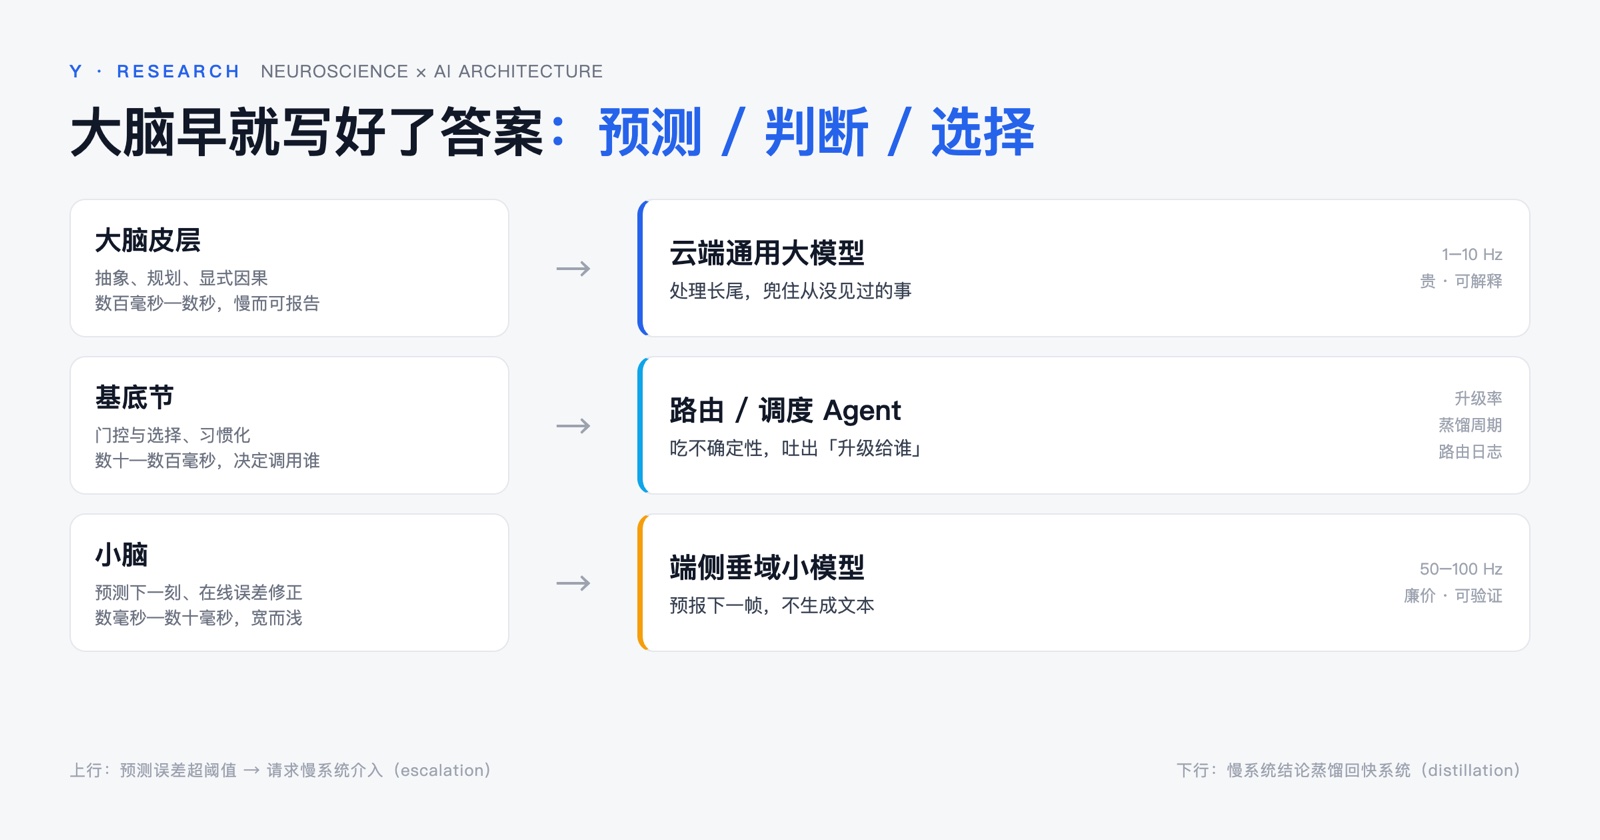
〇、一句话结论
"直觉靠小脑、思考靠大脑"这个说法只对了一半,而且错掉的那一半恰恰是最有价值的部分。 大脑真正的分工不是"直觉 vs 思考",而是"预测 vs 判断"——小脑负责在毫秒级预测"下一刻会发生什么",皮层负责在秒级判断"我该做什么",基底节负责在两者之间做门控与选择。
你设想的那套架构——云端通用大模型负责深思与决策、垂域小模型负责高频执行、具备调度与自我进化能力的 Agent 负责路由——不只是"代表未来",它已经在 2026 年被三个互不相干的行业(通用 Agent、智能驾驶、具身智能)同时选中了。这不是英雄所见略同,这是物理约束下的唯一解。
而最新的证据来自本月:TypeSafe AI 于 2026 年 9 月 15 日走出隐身模式,发布了一个不生成文本、只输出"带概率的类型化决策"的模型 Jev,延迟 70–500 毫秒,输入定价 0.042 美元/百万 token、输出免费,种子轮 4000 万美元、估值约 2 亿美元7·8。它的创始人 Diogo Almeida 是前 OpenAI 研究员、RLHF 与 InstructGPT 的共同作者之一。他们给这类模型的命名非常直白:System One Model。
你凭直觉猜到的东西,正在被人用 2 亿美元的估值写成招股书。
一、先纠正一个流传很广的说法:直觉不在小脑
1.1 这个说法对了一半,而错的部分更有趣
"小脑管直觉、大脑管思考"是科普界流传最广的简化之一。它的问题不在于错,而在于它把三个系统压缩成了两个,而真正被抹掉的那个(基底节)恰恰是 AI 架构里最关键的那一层——路由。
准确的说法是:
| 结构 | 它真正干的事 | 时间尺度 | 工程隐喻 |
|---|---|---|---|
| 大脑皮层 | 抽象、规划、语言、显式的因果推理;慢、耗能、可报告 | 数百毫秒—数秒 | 云端通用大模型(LLM/VLM) |
| 基底节 | 门控与选择:启动哪个动作序列、抑制哪个;习惯化、强化学习式的价值更新 | 数十—数百毫秒 | 路由器 / 编排 Agent |
| 小脑 | 预测:给定当前状态与动作,预测下一刻的感觉后果,并用预测误差在线修正 | 数毫秒—数十毫秒 | 端侧垂域小模型 / 策略网络 / 前向模型 |
直觉不是一个器官的产物。它是基底节把大量经验压缩成"可直接执行的块"(chunking),皮层来不及或不值得介入时,系统直接输出那个块的结果。基底节损伤的帕金森患者能"想明白"怎么走路,却无法自动起步——这证明自动化的那套回路是独立的硬件,不是"思考变快了"6。
所以,"老司机遇险一脚刹车"这件事里:小脑在预测车身姿态与轮胎抓地,基底节在调用那个练了十年的"紧急制动程序块",皮层要到事后才知道发生了什么。直觉是三者合谋,小脑只负责其中的"预演"。
1.2 小脑真正的角色:它不是直觉中枢,是预测器
近两年神经科学对小脑的理解发生了明显转向,从"运动协调器官"改为"通用预测器"。三条关键证据:
- *2025 年 Discovery Medicine 的综述提出:小脑的前向模型可以用卡尔曼滤波统一解释,而且这套机制不只服务运动,还扩展到认知、情绪与社会推理——小脑在做的核心计算是序列(sequencing)与预测(prediction)*1。
- Tsay 与 Ivry(arXiv, 2025)给出三条硬约束:预测性(做预期计算,不是反应计算)、短时程(预测只覆盖很短的时间窗)、连续性(变换的是空间、时间这类连续量而非离散符号)2。这篇论文最有价值的地方是它明确了边界条件:哪些计算不该依赖小脑。
- *2025 年 NeuroImage 在 151 名健康人身上发现,小脑特定区域的白质微结构(FA 值)与长时记忆、抽象推理、语言相关执行功能显著相关,与反应时负相关——作者解释为:小脑通过更新内部模型、校正预测与结果的偏差*来提升认知表现3。
- *2025 年 Journal of Neuroscience 在猴子身上记录到:小脑皮层浦肯野细胞编码时间预测信号,而齿状核单个神经元的放电可以被约 16 个浦肯野细胞的线性组合解释 84%——这意味着小脑的输出是一种极高维特征展开后的线性读出*4。
最后这一条,是整个报告里最重要的一个技术隐喻。
1.3 小脑不是"小模型",它是"极宽的浅层网络"
大众认知里"小脑 = 小",其实是个误会。按神经元数量算,小脑拥有全脑一半以上的神经元(常见估计在 500–700 亿量级,而整个大脑皮层约 160 亿),它体积小只是因为颗粒细胞极其微小。它的结构是:颗粒细胞把输入做极高维、极稀疏的展开,然后浦肯野细胞做近乎线性的读出。
翻译成工程语言就是:随机特征展开 + 线性读出——一个又宽又浅、参数效率极高、单次前向传播极快的结构。
这就是为什么"垂域小模型"不该被理解为"缩小版的大模型"。生物学的答案恰恰相反:快系统不是被压缩的慢系统,它是一个结构完全不同、靠宽度而非深度取胜的东西。 cerebellum 的均一"晶体结构"也是工程上最宝贵的性质:可标准化、可复制、可替换、可独立验证——你可以量产的模块,长这样。
1.4 更锋利的修正:分工不是"直觉 vs 思考",是"预测 vs 判断"
把上面的证据收拢,我建议把那个流行说法改写为:大脑皮层负责"判断该做什么",小脑负责"预测会发生什么",基底节负责"决定这一次调用谁"。
这个改写之所以重要,是因为它直接给出了工程上的三条设计原则:
- 预测层的输出必须是连续量、短时程、可在线修正的——不是让小模型去"回答",而是让它去"预报下一帧"。
- 判断层的价值不在于它多快,而在于它能处理"从未见过"的东西——通用性的全部意义是兜住长尾。
- 选择层(路由)是独立的、可被训练的——它吃的是"不确定性",吐的是"调用谁"。
二、把大脑翻译成工程:一张对照表
| 生物结构 | 计算特征 | 工程对应(2026 年现实) | 现行实例 |
|---|---|---|---|
| 大脑皮层(异质、昂贵、慢、可报告) | 通用、可解释、处理长尾 | 云端前沿大模型 / VLM,1–10 Hz 级 | GPT-5 thinking 系列9、Claude/Gemini 前沿档 |
| 基底节(门控、选择、习惯) | 吃不确定性、做信用分配、做动作选择 | Router / Orchestrator / 置信度级联 | GPT-5 实时路由模块9、企业侧三级推理路由11 |
| 小脑(均一、宽而浅、局部学习规则) | 毫秒级预测、在线误差校正、无反向传播 | 端侧垂域小模型 / 策略网络 / 前向模型 | Jev(System One Model)7、车端 7B 蒸馏模型12、AstraBrain-WBC 0.515 |
| 感觉预测误差(爬行纤维) | 全局"意外信号",触发局部突触修正 | 升级信号(escalation trigger)/ 失败检测 | 置信度级联、recovery branch13 |
| 睡眠巩固 / 离线重放 | 慢系统结论回流到快系统 | 蒸馏 + 数据回流 + 部署后训练 | 32B→7B 蒸馏12、闭环强化学习 Momenta R712 |
2.1 被忽略的第三条:不只有"快慢",还有"上下"
大部分关于"双系统"的讨论只讲了快慢,但生物系统里真正让它成为一个系统而非两个系统的,是两条纵向通路:
- 上行通路(快 → 慢):当预测误差超过阈值(爬行纤维放电),请求慢系统介入。工程上叫 escalation / 置信度级联 / recovery branch。没有这条路,快系统会安静地在自己不擅长的场景里犯错。
- 下行通路(慢 → 快):慢系统的结论最终要固化进快系统(睡眠巩固、离线重放)。工程上叫蒸馏、部署后训练、技能库沉淀。没有这条路,你永远在为同一个问题付两次钱。
判断一个系统是不是"真双系统",就看这两条通路是否闭合。 只把大模型和小模型并排放着、各自干各自的,那是两个产品,不是一个系统。这句话可以直接拿去做尽调。
三、产业已经在投票:三个领域同时收敛到同一架构
这不是理论推演。2026 年,三个原本各走各路的行业,几乎同时收敛到"大模型 + 小模型 + 路由"这一形态。
3.1 通用 Agent:从"一个全能模型"到"三级路由 + 置信度级联"
- GPT-5 本身就不是单一模型。 其 System Card 披露的是一个由路由模块驱动的多模型系统:
gpt-5-main(高吞吐快响应)、gpt-5-thinking(深度推理)、以及一个实时路由模块,依据对话类型、复杂度、工具需求与用户意图实时决定调用谁,并用真实信号(用户切换行为、偏好率、正确性度量)持续训练9。"模型"与"产品"的分离已经完成:用户感知到的是体验,底层是动态路由的模型组合。
- NVIDIA 的研究观点被产业界广泛转述:典型 Agent 中 60–80% 的调用是 routine 步骤,小模型完全能胜任10。在界定清晰的后台流程里,80–90% 的步骤留在本地是常态。
- 2026 年生产环境的默认形态是三层推理:端侧(1B–14B 量化模型,零延迟、零边际成本、数据不出域)→ 私有云(14B–70B)→ 前沿云(最贵、最强)——路由层按任务复杂度、数据敏感度、置信度三维决策11。
- TypeSafe AI 的 Jev(2026 年 9 月 15 日)是这条路线最激进的表达:它不生成文本,只返回类型化的概率决策(Choice / Score / Noul 三种原语),并行输出而非逐 token 采样,因此延迟 70–500 ms,输入 $0.042/百万 token、输出免费(因为它没有 token 可计价)7·8。
需要泼的冷水:TypeSafe 自述的"快 40–200 倍""成本 445 倍优势"是自家基准、且参照系是其他模型的输出平均值,未经独立验证8。更关键的是,他们宣称 Jev"不可能幻觉"——这个保证只在结构层面成立(输出不可能越出预定义类型),但一个类型正确、实质错误的决策仍然是错的。这一点他们自己在文档里也承认了7。把它当成"决策正确性保证"来采购,会是 2026 年最贵的误解之一。
3.2 智能驾驶:VLA 做大脑、端到端做小脑、世界模型做"沙盘"
智驾是这套架构最成熟、也最有说服力的落地场,因为它的物理约束最硬(毫秒级、不可重试、出错即事故)。
2026 年的行业格局(据行业研究报告与公开报道)12:
- 地平线:"快思考 + 慢思考"双轨架构,以强化学习为中枢——一边用世界模型+仿真训练赋能端到端直觉模型(毫秒级响应),一边用推理增强赋能 VLM 认知模型(长时序复杂场景),最终把 VLM 能力蒸馏、量化到车端。
- 千里科技:VLA 做慢系统高阶决策、E2E 做快系统行动映射;32B 参数大模型做多模态预训练 → 蒸馏为 7B 轻量模型部署车端,再用强化学习对齐人类驾驶风格与安全约束。这条链路几乎就是"下行通路"的教科书实现。
- 小鹏:物理世界基座模型同时包含第二代 VLA 与世界模型。刘先明在 CVPR 2026 的表述很精准:VLA 学的是"如何行动",世界模型学的是"行动之后世界会如何变化"——这不是路线之争,是同一系统的两个半脑。
- 理想:路线几经切换(规则 → 端到端 → 端到端+VLM 双系统 → VLA → MindVLA-01),2026 年全面转向 MindVLA-01 统一基座:原生多模态 MoE-Transformer + 3D 空间理解 + 预测式隐世界模型 + 统一动作生成 + 大规模闭环强化学习。
- Momenta:R7 强化学习世界模型量产首发,基于超 120 亿公里真实里程;三段式"预训练 → 仿真 → 强化学习"。
- 华为 WEWA 2.0:多智能体博弈 + 云端在线强化学习。
一个特别值得注意的工程细节:安全冗余正在被重新制度化——L3/L4 推动"传统算法兜底 + 端到端主系统"成为刚需(英伟达快慢双系统、地平线 Lite Safety Checker、博世安全门控 PDMS 奖励)12。这在生物学上等价于:小脑和脑干反射不依赖皮层,皮层挂了人还能呼吸。 任何声称"纯端到端无需兜底"的方案,都还没通过这一关。
3.3 具身智能:双系统已是默认答案,竞争转向"接口"与"通用小脑"
- 主流 VLA(GR00T、Helix、π0 系列)全部采用不对称双系统:System 2(5–10 Hz 的视觉语言模型,负责理解与重规划)→ System 1(50–100 Hz 的扩散/流匹配专家,负责出动作)。动作分块(action chunking)是让这套设计成立的工程关键:一次前向预测 8–50 个未来动作,模型跑 5–10 Hz、机器人执行 50–100 Hz,把推理频率与控制频率解耦16。
- τ0-VLA(上海创智学院 + 智元,WAIC 2026):把"测试时计算"和世界模型推演首次引入具身上层决策。高层慢系统内含候选任务生成、世界模型推演、价值评估、反思四个模块,构成子任务级束搜索——行动前先花算力"想"。结果:全屋清洁、烹饪、制作奶茶等长程任务平均成功率从 27.5% 提升到 45.0%13。预训练用了 4 万余小时真实物理交互数据(含 2 万+ 小时真机数据)。
- EMS(arXiv, 2026 年 8 月)指出了当前双系统的真问题:快模块被紧耦合在慢模块的中间表示上,必须端到端联合训练,导致无法模块化替换。他们用强化学习训练的切换策略在两个完全解耦的系统间动态选择,在 LIBERO 上把有效动作频率提到 93.4 Hz,同时保持大基线模型的成功率14。
- AstraBrain-WBC 0.5(银河通用,CVPR 2026):被称为"全球首个人形机器人通用小脑 GPT 基座大模型"。80.4M 参数、20 亿帧人类动作数据、因果 Transformer、双阶段训练(300 个 PPO 专家 → DAgger 蒸馏为单一模型),端到端推理延迟低于 1.5 毫秒,并首次在运动控制领域验证了 Scaling Law(数据从 200 万帧到 20 亿帧,成功率 83.26% → 92.58%)15。
- CT-VAM(arXiv 2606.09572):受小脑—丘脑通路启发的视觉-动作模型,主张语言只用于指定任务意图、不应在高频底层执行中被反复处理——这正是对"小脑不做离散符号运算"这一生物学约束的工程呼应。
一个清晰的产业信号:机器人领域已经开始用"大脑/小脑"来命名产品线。当生物学隐喻变成产品命名,说明架构共识已经形成。
四、为什么这不是潮流而是物理:四条硬约束
约束一:时延与带宽的物理
闭环控制的频率(50–100 Hz)与前沿模型推理的频率(1–10 Hz,深度思考模式下甚至 0.01 Hz)相差一到四个数量级。云端往返时延在物理上无法进入控制回路。这不是优化问题,是可行性问题。 只要系统要接触物理世界,快层就必须本地存在。
约束二:成本必须与难度对齐
token 经济学的裂缝已经很明显:一个 Agent 请求会触发 5–50 次模型调用,其中 70–85% 是分类、抽取、格式化这类 routine 步骤10·11。前沿模型的价格是快模型的 10–100 倍。用前沿模型做"从 PDF 里抽一个日期"是在烧钱买确定性。 混合架构在产业实践中普遍报告 70–90% 的成本下降,且质量损失在 2% 量级11·13。
约束三:可验证性——只有被限制的模块才能被认证
这是最被低估的一条。大模型不可穷举验证,小模型在限域内可以。 当系统要进入医疗、金融、驾驶、工业控制这类受监管领域,你需要一个"可以被证明行为有界"的层。Jev 的核心卖点不是快,是类型安全——一种结构性保证7。同理,智驾的安全门控、机器人的运动学约束层,都是这个逻辑。
推论:未来的合规架构,一定是"不可验证的强能力层 + 可验证的弱能力层",而不是"一个努力变得可信的强能力层"。
约束四:进化速度——经验落在哪一层,决定系统的迭代周期
2026 年清华与衔远科技联合发布的综述给出了一个非常有力的框架17:Agent 系统由基座模型 / 可变状态化 Harness / 用户侧 / 环境侧四部分构成,而 Harness(技能、记忆、工具配置、验证规则)才是经验进化的核心载体——因为它比模型权重更新更快、更易治理和回滚。
同一框架把经验落地分为快路径(写入 Harness:技能、记忆、工具,分钟级、可回滚)与慢路径(训练内化进权重,周月级、迁移性好)。
这与大脑的双通路完全同构:快路径 = 小脑的在线突触修正,慢路径 = 皮层的睡眠巩固。
工程推论非常直接:一个自进化系统的竞争力,不取决于它能不能改自己,而取决于经验落在哪里、多久能落、错了能不能回滚。RSEA 的发现值得每个做 Agent 的人记住:未经门控的上下文进化方差极高且可能崩塌,必须靠 held-out 集做提交门控18。
五、五个可能反直觉的判断
判断一:"垂域小模型"应该是另一种物种,不是缩小版的大模型
Jev 的意义不在参数量,在于它放弃了生成。它不写文本,只返回带概率的类型化决策,因此输出免费、延迟 70–500 ms。这不是"小 GPT",这是一个决策原语。
我的判断:未来两年会出现一批"不能聊天"的模型。它们不可用于对话、不写诗、不写代码,但在自己的窄域里可以被形式化验证。产业会为它们单独定价、单独认证、单独监管。把小模型当成"便宜的大模型"来做的团队,会在 2027 年被这批原生决策模型打穿成本结构。
判断二:护城河正在从模型权重转移到"路由日志 + 升级/蒸馏闭环"
模型权重会商品化(开源、蒸馏、价格战)。但"哪一类问题应该升级、升给谁、升级后的结论怎么蒸馏回来、多久蒸馏一次"这套策略,是吃真实流量长出来的。它写在配置文件里,却长在业务数据上。
NVIDIA 的判断是对的:小模型是 Agentic AI 的未来10。但我要补一句更关键的:路由层才是那个"未来"的所有权人。 谁掌握路由日志,谁就掌握了:
- 全局的能力地图(哪里强、哪里弱、成本花在哪);
- 最好的微调数据集(升级样本天然是 hardest cases);
- 定价权(可以决定把多少流量导向自家的高毛利层)。
判断三:世界模型不是第三条路线,它是路由器内部的沙盘
VLA 派与世界模型派的争论("理解"优先 vs "预测"优先)是个伪二选一12。世界模型的真正位置是:给上层决策提供一个可低成本试错的推演空间,让慢系统能在行动前比较若干候选——τ0-VLA 的"先想再做"就是这么干的,长程任务成功率直接提升 17.5 个百分点13。
换句话说:世界模型是路由器的"想象模块",是 System 2 与 System 1 之间的共同语言。 谁把世界模型做成独立产品线,谁就输了;谁把它做成决策层的内置推演器,谁就赢了。
判断四:计价单位正在从 token 迁移到 decision
Jev 输出免费这件事,表面是定价技巧,实质是计量单位的变革:当你不再生成 token,"token"就不再是合适的计价物,取而代之的是"一次置信的决策"。TypeSafe 网站上的对比直接用了"每 1000 个 workflow 39 美分"这种口径7。
商业后果:一旦决策可被单独计价,企业就能精确计算"一个决策的边际成本"。当这个数字趋近于零,被自动化的就不再只是任务,而是判断本身。这会重塑一整批以"专业判断"收费的行业(初级法律、初级审计、保险核保、信贷初审、客服分诊)。
判断五:最大的风险不在能力,在"直觉层的不可审计"
这是我最担心、也最少被讨论的一点。
当系统的绝大多数决策由快层做出,而这些决策不可解释(小模型不产出理由,Jev 的概率不解释原因——这一点已被评论者明确指出7),我们会面临一个结构性困境:
系统越高效,就越难以解释它为何高效。
TypeSafe 自己的顾问也承认:概率能显示模型有多自信,但不能解释它为什么这么决定——在需要向监管方或审计方解释自动化决策的受监管行业,这个区别是致命的7·19。
这个问题在生物界有对应物:你可以问一个人为什么踩刹车,但他答不上来,因为做出决定的是基底节和小脑。人类靠"责任归属在皮层"这个社会契约解决了它;AI 系统里,皮层不是人。
六、还没解决的问题(诚实清单)
| 问题 | 为什么难 | 当前的薄弱答案 |
|---|---|---|
| 置信度校准 | 快层输出的"自信"与真实准确率往往不同步,且随数据漂移而漂移 | 概率阈值 + held-out 门控;但校准需持续在自有数据上验证7·19 |
| 升级阈值的自洽 | 阈值定低了成本失控,定高了快层静默犯错;最优阈值随场景漂移 | 强化学习学切换策略(EMS14);尚无通用解 |
| 责任归属 | 快层犯错、慢层没被调用、路由层决定不调用——三方无一是"人" | 安全兜底层 + 审计日志;法律上仍空白 |
| 自进化的塌缩风险 | 上下文/技能库的无门控进化方差极大,可能崩塌或奖励黑客 | held-out 提交的单调安全约束18;沙箱、回滚、人类审批边界 |
| 接口标准化 | 双系统紧耦合在中间表示上,无法模块化替换 | 解耦双系统 + 插件式替换(EMS14);尚无行业标准 |
| 端侧算力与能耗 | 高频快层在本地跑,功耗/散热是硬天花板 | 量化、蒸馏、专用芯片(Jetson Thor 等);大脑的 20 瓦仍是遥不可及的参照 |
七、商业、社会、哲学:三条尾巴
7.1 商业:当"判断"的边际成本趋近于零
过去两百年,专业阶层的护城河建立在"判断力稀缺"上。这套架构正在把判断力拆成两部分:可标准化的判断(被压缩进快层,成本趋零)与长尾判断(留在慢层,昂贵且稀缺)。
中间层会被抽空。这已经在智驾行业预演过一次:当端到端+VLA 把"常规驾驶"压缩进车端模型,驾驶技能的稀缺性就消失了,价值全部转移到数据闭环与规模上——Momenta 的 120 亿公里就是一个用规模换能力的例子12。
同样的故事会在法律、会计、影像阅片、软件工程里重演。判断标准很简单:你所在的领域,有多少比例的判断能被枚举成"Choice / Score"这类原语? 那个比例,就是你的护城河的下跌幅度。
7.2 社会:谁为直觉层的错误负责
这里有一个真正棘手的社会设计问题:我们建立了一整套围绕"人类决策"的责任制度(过错、注意义务、可预见性),而这套制度默认决策者可以给出理由。
快层给不出理由。它给概率。
三种可能的演化路径:
- 强制可解释层:要求高风险决策必须过慢系统,理由必须可陈述(代价是慢、贵);
- 结构性兜底:不要求快层可解释,但要求快层的行为有界(类型安全、安全门控、传统算法兜底)——这是智驾已经在走的路12;
- 责任上移:把责任压给部署者而非模型("你选了这套路由策略")。
我倾向于认为 2 + 3 会胜出,因为 1 在经济上不可持续。这意味着未来最具价值的法律与工程交叉岗位,是"路由策略的合规审计"。
7.3 哲学:意识可能是系统里最不重要的一层
这套架构逼我们面对一个不太舒服的结论。
笛卡尔把"我思"确立为人的本质,此后四百年我们都默认思考是智能的高级形态,其余都是低级辅助。但神经科学给出的图景恰恰相反:意识只是系统里最慢、最耗能、带宽最低、且只在系统搞不定时才被唤醒的那一层。有估计认为非意识处理的信息量比意识处理高出几个数量级(这类"11M bits/s vs 40 bits/s"的数字在科普中被广泛引用,但原始出处薄弱,当作量级直觉而非精确事实看待更稳妥)。
我们之所以觉得思考重要,可能只是因为它是唯一被广播到"我们"这个叙事里的那部分。
如果这个判断成立,那么今天 AI 领域最热闹的那部分——让模型更会"想"、更能"说清楚它怎么想"——可能只是在打磨系统里最薄的一层。真正的智能革命发生在那些沉默的、高频的、不可言说的层里:它不解释,它只是每次都对。
而这带来一个文明层面的风险:我们把"可解释性"当作 AI 对齐的核心抓手,但如果智能的主体本来就不可解释,我们可能是在为一个注定无法达成的标准,延迟一个本来可以安全落地的系统。 更可能的答案是:对齐的落点不是"让 AI 说清它怎么想",而是"让 AI 的行为有界、可回滚、可兜底"——像小脑那样,而不是像哲学家那样。
八、给三类人的可执行建议
给创始人/产品负责人
- 不要问"用哪个模型",要问"我的系统里哪一层负责升级、哪一层负责蒸馏"。画不出这两条纵向通路的架构图,就不是双系统。
- 尽早把路由日志当成一级资产来建设(记录:谁处理、为什么升级、置信度、结果反馈)。这是未来唯一不可复制的东西。
- 给每个快层模块设计"类型边界"而非"性能目标"。能被形式化约束的模块,才能进受监管市场。
给投资人
- 尽调问题从"模型多强"改为三个:升级率是多少?蒸馏周期是多久?路由日志有多大?
- 警惕两类公司:宣称"一个模型解决所有问题"的;以及宣称"我们的小模型又快又便宜又不会错"却拿不出第三方校准数据的。
- 关注"决策即服务"这条新赛道——定价单位从 token 变成 decision 的那一天,会出现新的定价权中心。
给从业者/研究者
- 值得深耕的三个方向:切换策略(何时升级)、校准(概率是否可信)、接口解耦(能否热替换快层)。这三个是当下最薄弱、也最缺人的地方。
- 别再卷"让小模型更像大模型"。去做"大模型做不到的事":类型化、可验证、在线自适应、毫秒级。
- 读一读小脑的局部学习规则(无反向传播、延迟误差信号驱动)5。在线自适应——部署后单次试验内修正——是目前机器人与智驾公认的痛点,而生物界早就有了答案。
九、结语
回到最初那个问题:"直觉靠小脑,思考靠大脑",是真的吗?
答案是:它是一个好的起点,但是一个坏的终点。
好的起点,是因为它抓住了智能最根本的分层——快与慢、预测与判断、执行与规划。坏的终点,是因为它漏掉了中间那个真正让系统成为系统的东西:选择谁上场的那一层。
而你设想的那个架构——大模型负责深思、垂域小模型负责执行、Agent 负责调度与进化——恰恰补全了这一层。它不是"代表未来的方案之一",它是在时延、成本、可验证性、进化速度四条硬约束同时作用下,复杂系统唯一能长成的形状。大脑用了五亿年收敛到它,工程界用了五年。
最后留一句可能有用的提醒:神经系统里最强大的那部分,从不说话。 未来最强大的那部分 AI,大概也不会。
参考与出处
- Kakei S., Tanaka H., Mitoma H., Manto M. The Cerebellum as a Predictor: Recent Insights Into Cognitive Control and Extension of Kalman Filter Theory to Cognition. Discovery Medicine, 2025, 37(196): 791-800 ↗
- Tsay J., Ivry R. Cerebellar Contributions to Action and Cognition: Prediction, Timescale, and Continuity. arXiv:2509.09818, 2025 ↗
- Urbini N. et al. The cognitive cerebellum: linking microstructure to cognitive functions in a healthy population. NeuroImage, 2025, 317: 121356 ↗
- Okada K., Kameda M., Tanaka M. Comparison of Signals from Cerebellar Purkinje Cells and Deep Nuclei during Temporal Prediction in Primates. Journal of Neuroscience, 2025, 45(49) ↗
- Robot Learning Part 5: Six Architectural Principles from Motor Neuroscience(小脑局部学习规则、准备—执行分离) ↗
- 直觉决策的神经回路(基底节、眶额皮层、前岛叶、体标记假说) ↗
- SiliconANGLE. TypeSafe AI exits stealth with $40M to build AI for use by software. 2026-09-16 ↗
- AI Insiders. TypeSafe launches Jev, a model built to decide, not to talk. 2026-09-16 ↗
- GPT-5 System Card 深度解读:统一路由架构 ↗
- Superkind. Small Language Models on EU Soil: The On-Prem Agentic Architecture(引 NVIDIA Peter Belcak 观点:60–80% 的 Agent 调用可由小模型承担) ↗
- Zylos Research. Local-First AI Agents: Hybrid Cloud-Edge Architectures. 2026-05-10(三层推理架构与置信度级联) ↗
- 《2026 智驾大模型研究:技术博弈与范式融合进入关键期》(地平线、千里科技、小鹏、理想 MindVLA-01、Momenta R7、华为 WEWA 2.0、安全冗余) ↗
- τ0-VLA 发布:双系统架构 + 世界模型推演,让机器人学会先想再做(2026 WAIC;长程任务成功率 27.5% → 45.0%) ↗
- Sun Y. et al. Fast and Accurate: An Adaptive VLA Inference Framework through Environment-aware Model Selection. arXiv:2608.06434, 2026-08 ↗
- AstraBrain-WBC 0.5:人形机器人通用小脑 GPT 基座大模型(CVPR 2026;80.4M 参数、20 亿帧、<1.5ms、Scaling Law 验证) ↗
- Physical AI and Vision-Language-Action Models(VLA 架构、动作分块、System 1/System 2 双系统) ↗
- 衔远科技 × 清华《Self-Improving Agents in the Era of Experience》综述:Harness 作为经验进化载体、快/慢双路径. 2026-06 ↗
- RSI 综述:Agent 的递归自进化与 Self-Evolving Agents(RSEA held-out 门控、Voyager 技能库、AFlow、DGM 等) ↗
- InfoWorld. TypeSafe AI's new models work with machines, not humans(关于概率可解释性与审计风险的评论) ↗