Context Language Models:当 AI 开始编辑自己的记忆
上下文不再是一条只增不减的日志,而是一个模型可以用 Bash 随意改写的文件——结果是更准、更便宜、还能被训练。
- 论文:Context Language Models(arXiv 2609.37725),2026-09-29 提交
- 团队:Rulin Shao 等 13 人 · 华盛顿大学 × Meta Superintelligence Labs × MIT × Trillium Labs
这是一份融合技术、商业、社会与哲学视角的论文洞察报告。
〇、一句话导读
论文把 AI 系统里最后一块由人类代码把守的领地——"上下文该怎么管"——彻底交还给了模型自己:上下文不再是一条只增不减的日志,而是一个模型可以用 Bash 随意改写的文件。结果是:更准、更便宜、还能被训练。
这不是又一篇"更好的 RAG"或"更好的记忆系统"论文。它动的是 2026 年 AI 工程的核心地基:agent harness(脚手架)。过去两年,工程师们围绕"上下文窗口有限"这一现实,建造了庞大的脚手架体系——阈值触发的摘要压缩、向量检索、记忆卸载、子代理分工。这篇论文用一组漂亮的实验证明:这些人类精心设计的策略,全面输给"让模型自己想怎么管"。这是 The Bitter Lesson(苦涩的教训)在上下文工程领域的一次正面显灵。
一、论文速览
| 项目 | 内容 |
|---|---|
| 标题 | Context Language Models(CLM,上下文语言模型) |
| arXiv | 2609.37725,2026-09-29 提交 |
| 团队 | UW(Rulin Shao、Luke Zettlemoyer、Pang Wei Koh 等)+ Meta Superintelligence Labs(Mike Lewis、Wen-tau Yih)+ MIT + Trillium Labs(Nathan Lambert) |
| 核心主张 | 上下文管理应从外部 harness 的固定策略,变为模型的内生能力 |
| 一句话方法 | 把活上下文镜像成一个文件,模型用 Bash 无限制地编辑它 |
| 关键数字 | 准确率最高 +11.4%(相对),计算量最多 −59%,RL 后小模型 +47.6%,serving 再省 35% |
| 地位 | HuggingFace Daily Papers 热榜;被社区称为"harness 时代的终结之作"(略夸张,后文细说) |
二、核心思想:上下文从"日志"变成"文件"
2.1 一个两行的数学对比,却是范式之别
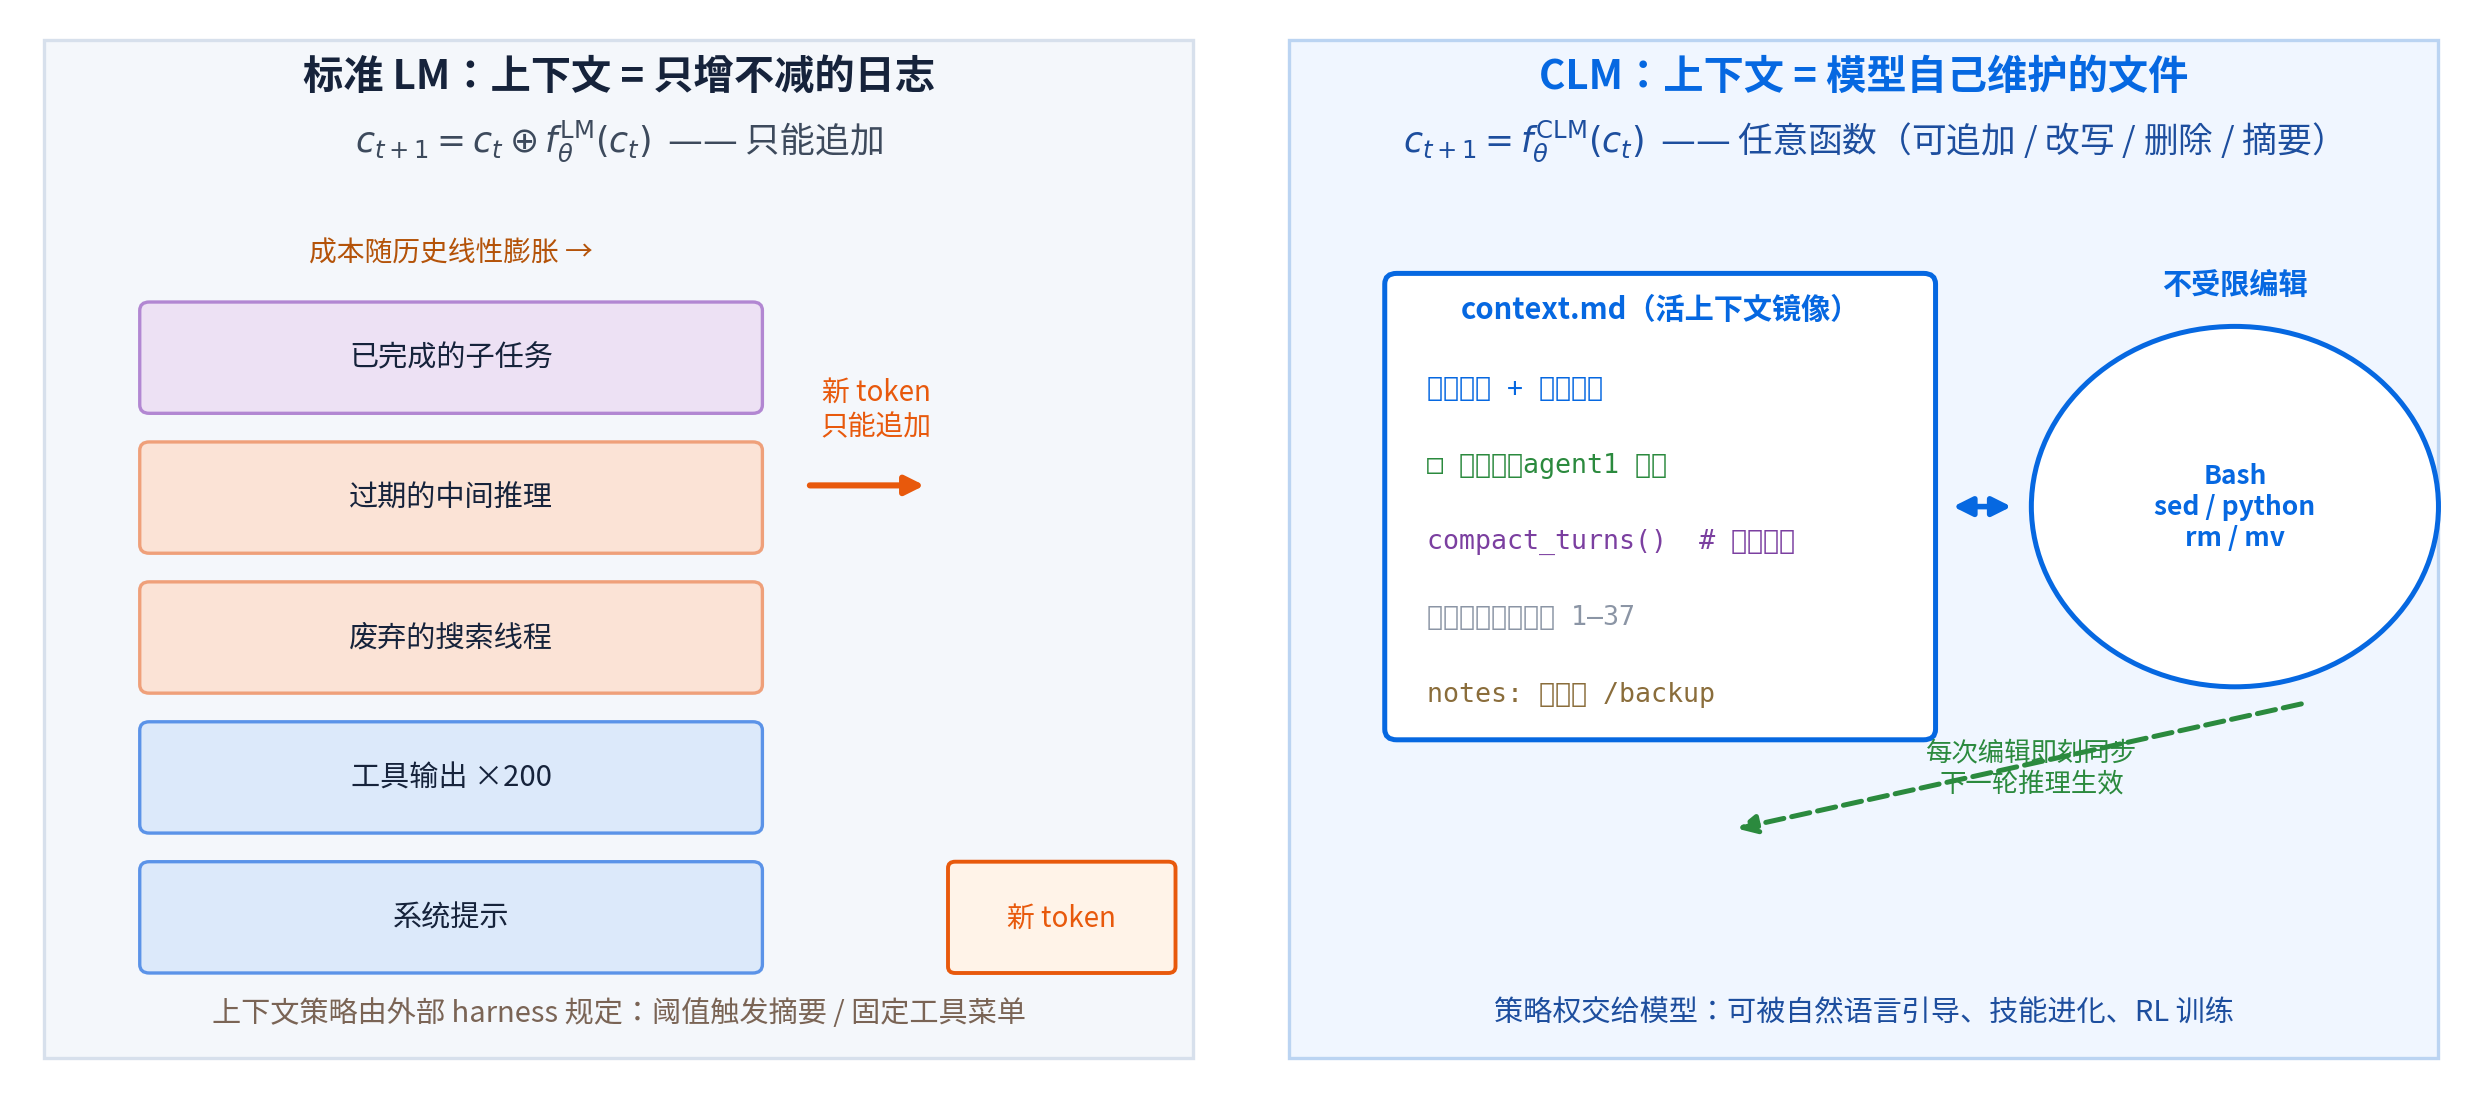
论文的形式化极简,但分量极重:
- 标准 LM(append-only,只增不减):
c(t+1) = c(t) ⊕ f_LM(c(t))
- CLM(上下文转移是模型控制的任意函数):
c(t+1) = f_CLM(c(t))
前者的下一刻 = 此刻 + 新增;后者的下一刻完全由模型决定——可以追加,可以改写,可以删除,可以摘要,可以给自己留便签。注意:这个定义把此前所有"上下文管理工具"(压缩、卸载、检索、折叠)都收编为 f_CLM 的特例——区别只在于那些方法把函数的定义权留给了 harness 的设计者,而 CLM 把定义权交给了模型本身。
2.2 实现:简陋到令人震惊
实现方式朴素得近乎"作弊":把上下文镜像成一个文件,把文件路径写进系统提示,模型用普通 Bash 命令(sed、python、rm)编辑它,每次编辑即刻同步回活上下文,下一轮推理即生效。模型不编辑时,新 token 默认追加。
多智能体扩展也同样自然:多个上下文文件共存——每个文件是一个 agent;创建文件 = 生成子代理,删除文件 = 终止子代理。没有编排框架,没有消息总线,文件系统就是多智能体协议。
2.3 为什么必须这么做:ContextBench 诊断
论文先自建了一个诊断基准 ContextBench(四个合成任务:Needle Retention 逐字保留、Sudoku Sketchpad 原地更新、KV Store 卸载检索、Log Triage 日志分诊),把上下文管理与推理能力解耦。结果辛辣:在 32K 上下文、最高 24 倍压力下,没有任何现有方法(摘要压缩、Context Folding、RLM、Self-Compact、ACM)能完美通过这些"不需要任何推理"的任务——摘要会丢失或幻觉信息,无原地编辑能力的方法每一步都在重算整个棋盘,能卸载的方法却不会按需驱逐。
洞察:这组实验的价值在于把一个含糊的工程直觉变成了清晰命题——上下文管理的失败,不是模型不够聪明,而是策略框架不够灵活。现有 harness 像是给一位能干的秘书只配了一台碎纸机(阈值触发摘要),而她真正需要的是一支笔。
三、战绩:四大战场,更准且更省
论文的核心实验覆盖从几分钟到 24 小时、从单代理到蜂群(swarm)的长时程任务,全部零样本(不训练,即插即用):
| 战场 | 对手 | 结果 |
|---|---|---|
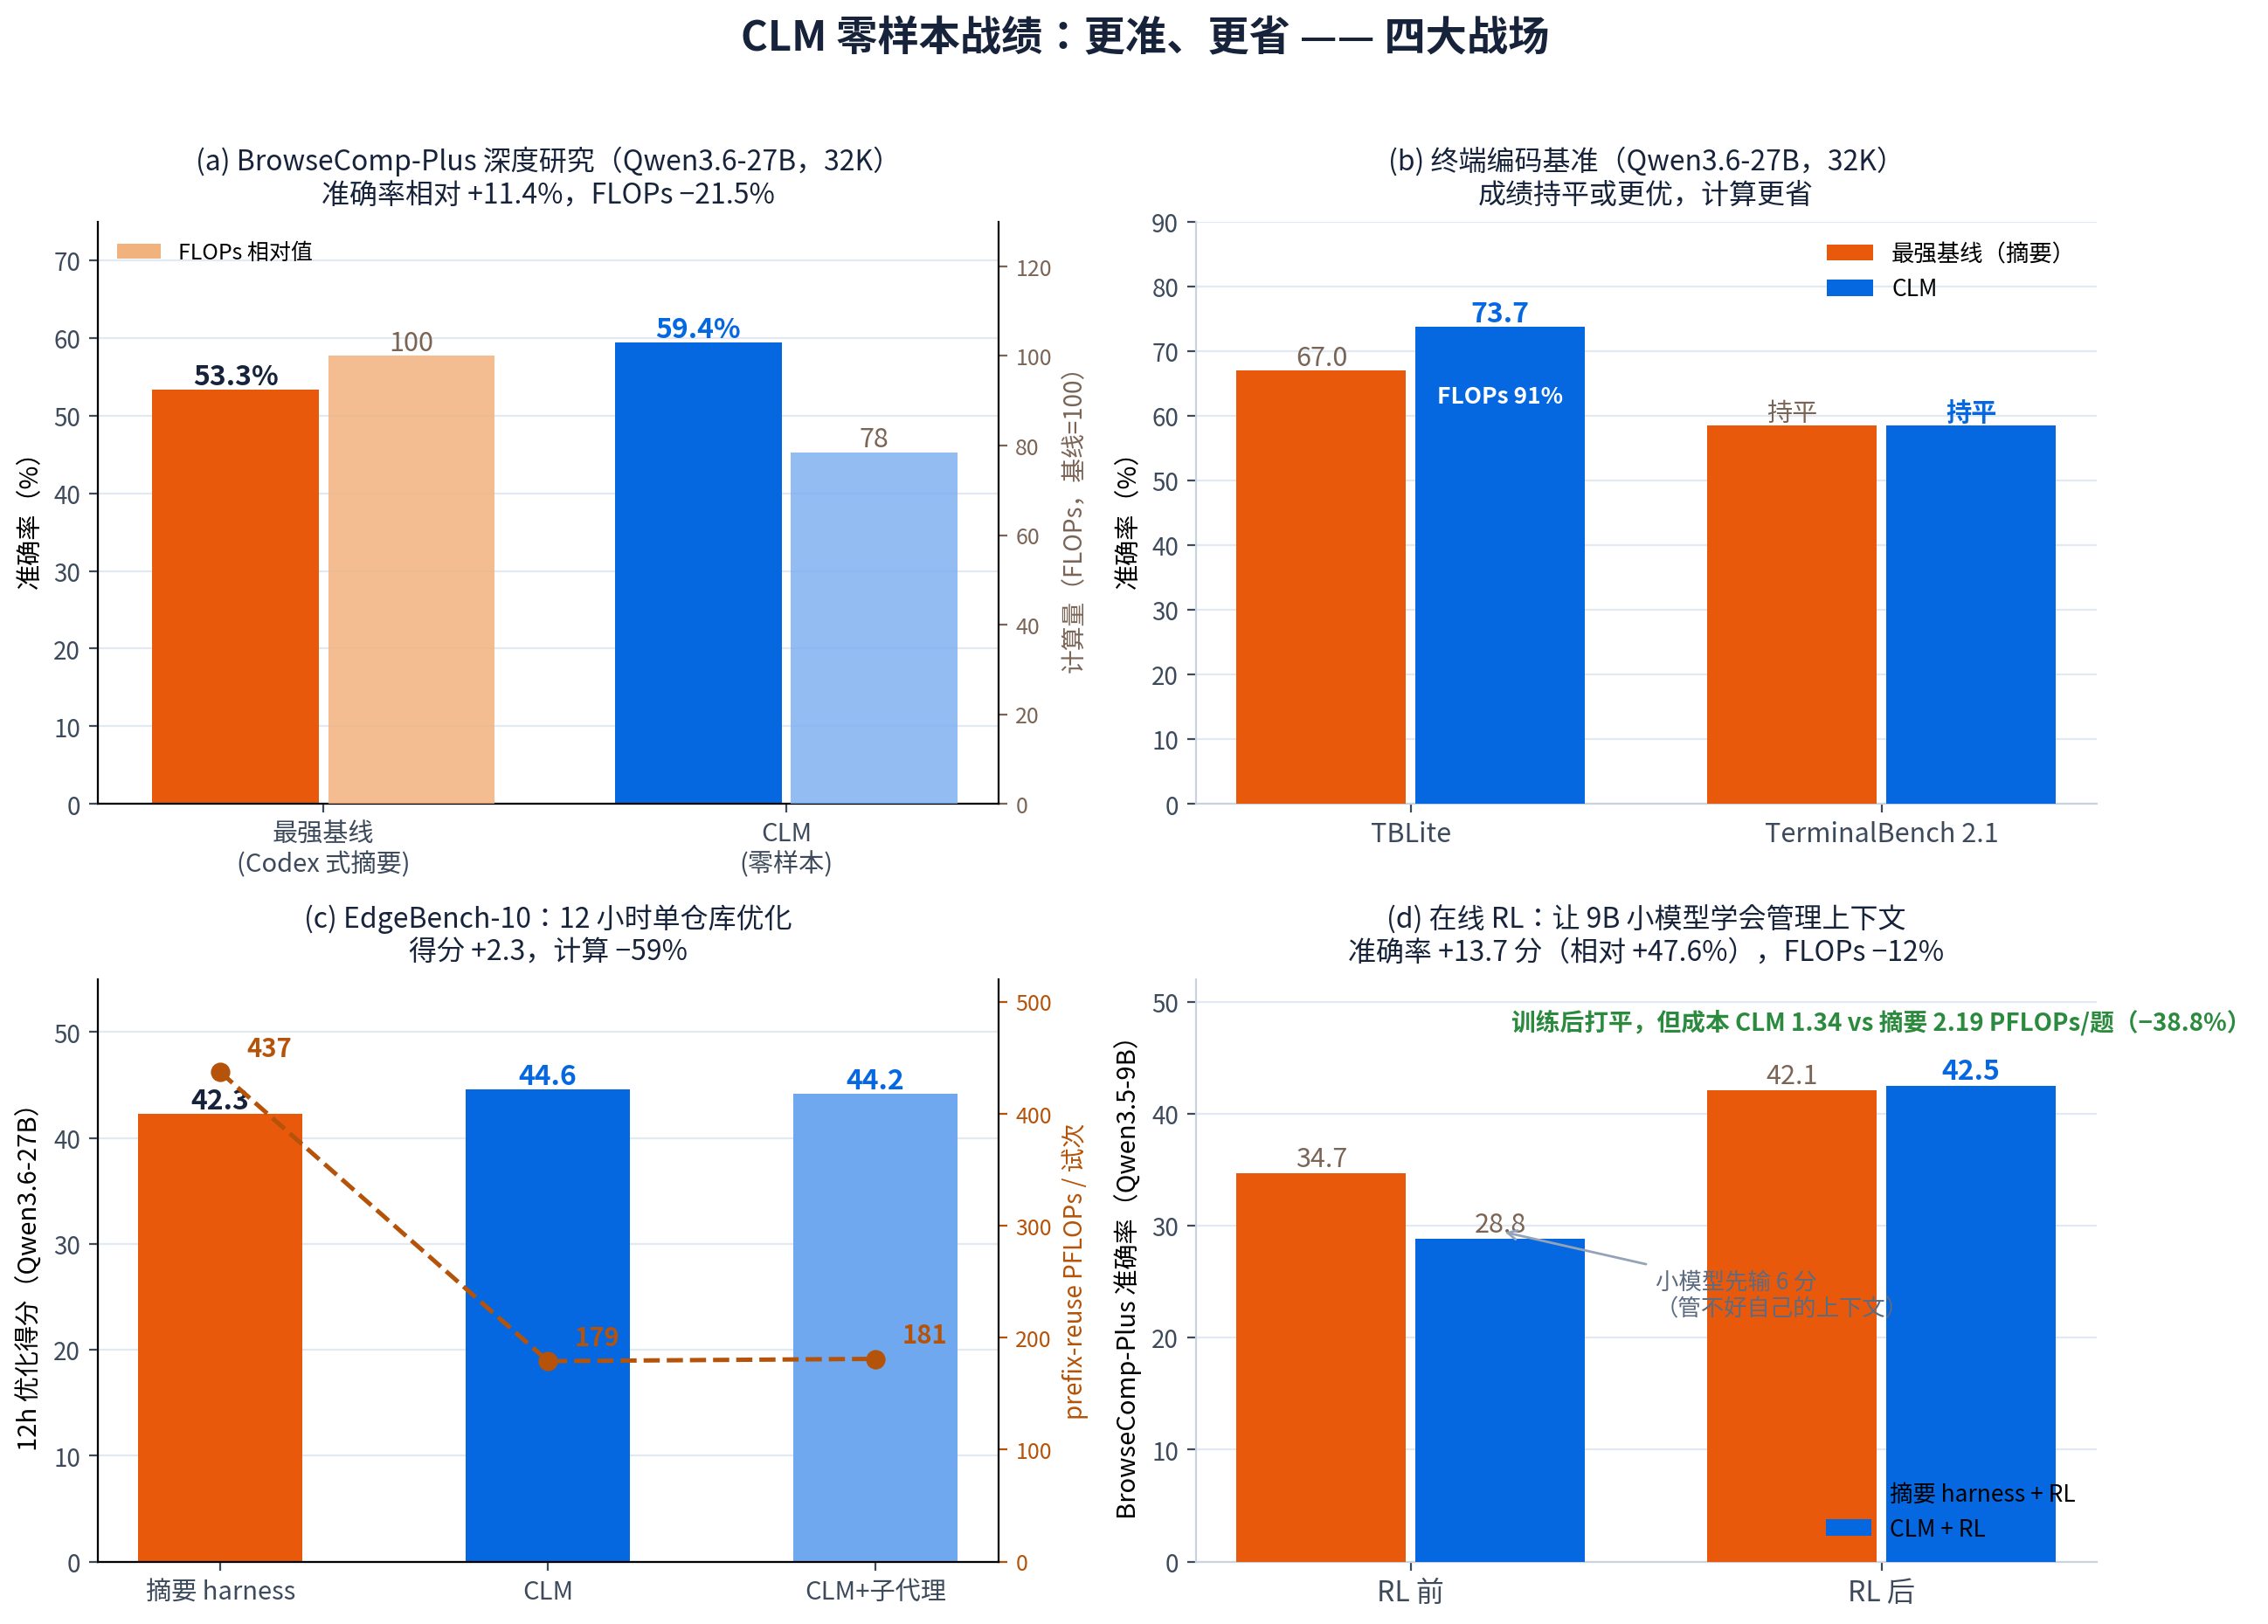
| BrowseComp-Plus(深度研究) | 最强基线 Codex 式摘要 | 准确率 59.4%,相对 +11.4%,FLOPs −21.5% |
| TerminalBench 2.1 / TBLite(终端编码) | 同上 | TB2.1 打平但 FLOPs −29.5%;TBLite 73.7% vs 67.0% |
| EdgeBench-10(12 小时单仓库优化) | Codex 式摘要 | 得分 44.6 vs 42.3,FLOPs −59%(179 vs 437 PFLOPs) |
| Software World(24 小时六仓库蜂群) | 摘要式代理蜂群 | 同等花费下,下游未见仓库的加速提升 多 65% |
| 数学优化(AlphaEvolve 同款四题) | OpenEvolve 专用进化框架 | 四题全胜(Heilbronn +16.8%) |
两个值得注意的细节:
- 通用胜过专用。在数学优化上,一个带 Bash 和一段进化算法提示的通用 CLM 代理,击败了 OpenEvolve 这种精心工程化的进化工作流。少即是多(less-is-more)被再次验证。
- 子代理不是万能药。单仓库任务上,CLM+子代理(44.2)并不优于纯 CLM(44.6)——多代理编排的收益是任务相关的。
3.1 学习三条路:会听话、能进化、可训练
上下文管理一旦变成模型行为,就自动获得了三种学习通道——这是论文比"省 FLOPs"更深一层的贡献:
- Steering(引导):一句话就能改变策略。"在上下文超过 X 时压缩"、"按语义子问题边界压缩"、"压缩前先备份"——无需改任何代码,代理照做。
- Skill Evolution(技能进化):用标准的提示进化循环(GEPA 式)优化一份"上下文管理技能文档",ContextBench 留出集准确率最高 +35.9 分,且进化出的技能可以严格支配(dominate)初始版本。
- Reinforcement Learning(强化学习):这是最有想象力的部分。论文设计 success-gated efficiency advantage——只在成功轨迹内部,按推理成本重排优势(失败的轨迹没有资格谈效率),用 stepwise GRPO 训练。结果:Qwen3.5-9B 从 28.8% → 42.5%(相对 +47.6%),且每题成本 1.34 PFLOPs(对照摘要 harness 训练后的 2.19)。
RL 那组数字里藏着一个重要的诚实发现:9B 小模型零样本用 CLM 反而比摘要 harness 差 6 分——小模型管不好自己的上下文;RL 之后准确率打平(42.5 vs 42.1),成本优势保持。换句话说,这个能力当前存在"规模门槛",但可以通过训练跨越。
四、被低估的另一半:Suffix Cache Reuse
如果说"上下文即文件"是论文的灵魂,那 Suffix Cache Reuse(SCR,后缀缓存复用) 就是让灵魂能在生产环境活下去的肉体。这部分被很多转述忽略,但对工程界可能更有价值。
问题:KV cache 的前缀复用假设上下文只追加。模型一旦改写历史中段(比如把 B 换成 B'),其后所有 token(哪怕一字未动的 C)的缓存全部失效,必须重新预填充。编辑越早,浪费越大——最坏情况下单轮成本是纯追加的 7.7 倍。
方案:SCR 在 prompt 差异中发现"幸存片段",把它们连同缓存状态一起搬迁到新位置——只需重旋转 RoPE 位置编码——只重算真正新增的 token。实测在 BrowseComp-Plus 上以标准 SGLang 65% 的计算量达到持平性能。
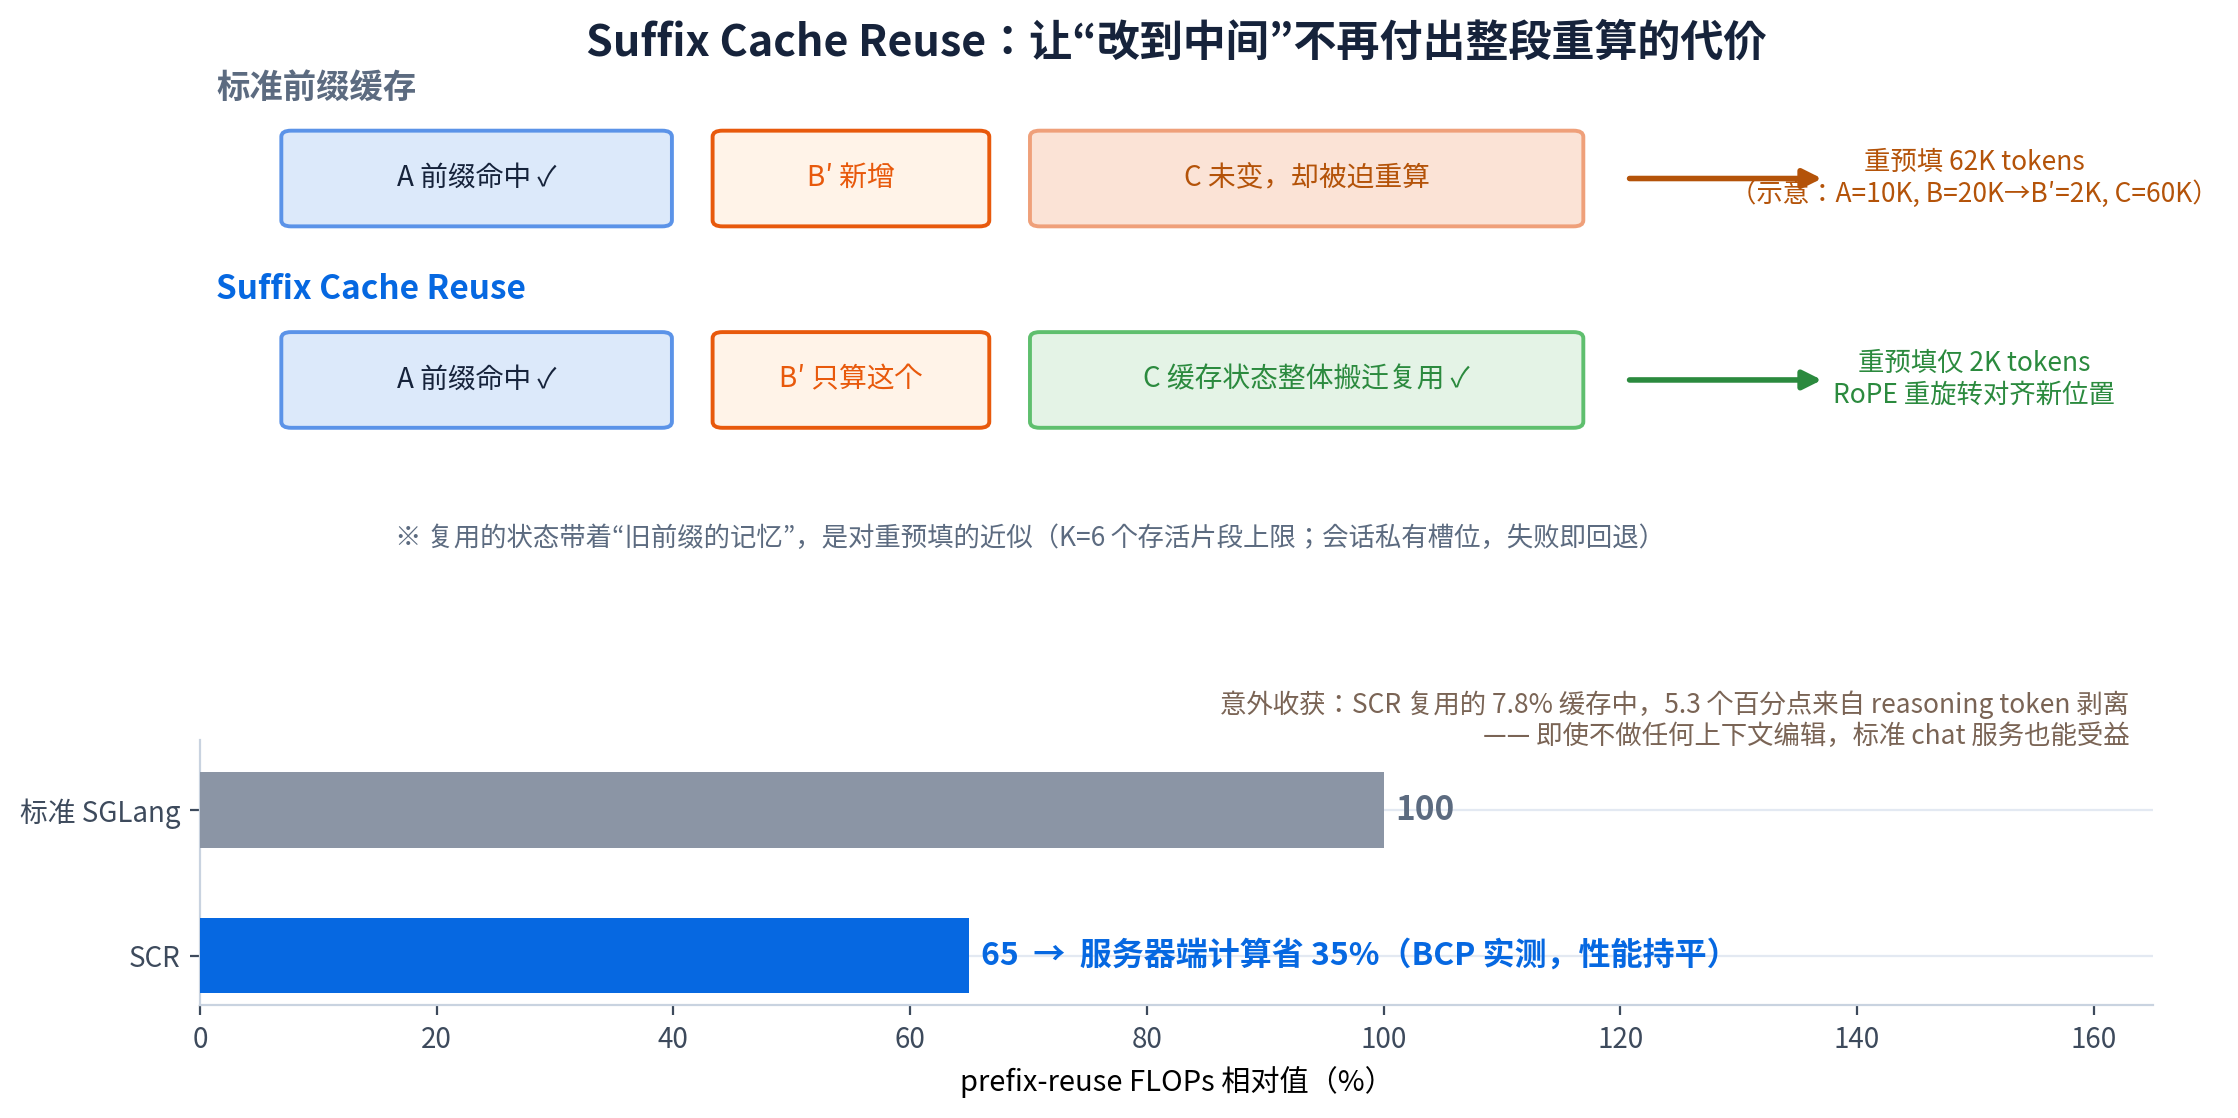
一个容易被略过的彩蛋:SCR 复用的缓存中 5.3/7.8 个百分点来自"reasoning token 剥离"(chat 服务普遍会在下一轮剥掉上一轮的思维链)——意味着即使你完全不用 CLM,标准推理服务也能从 SCR 受益。这是一个独立成立的 serving 优化,vLLM 和 SGLang 目前都没有内置。
五、涌现行为:没人教过,它们自己长出来的
零样本设置下,模型们发明了一套没人设计的上下文管理文化——这是全文最"科幻"的部分:
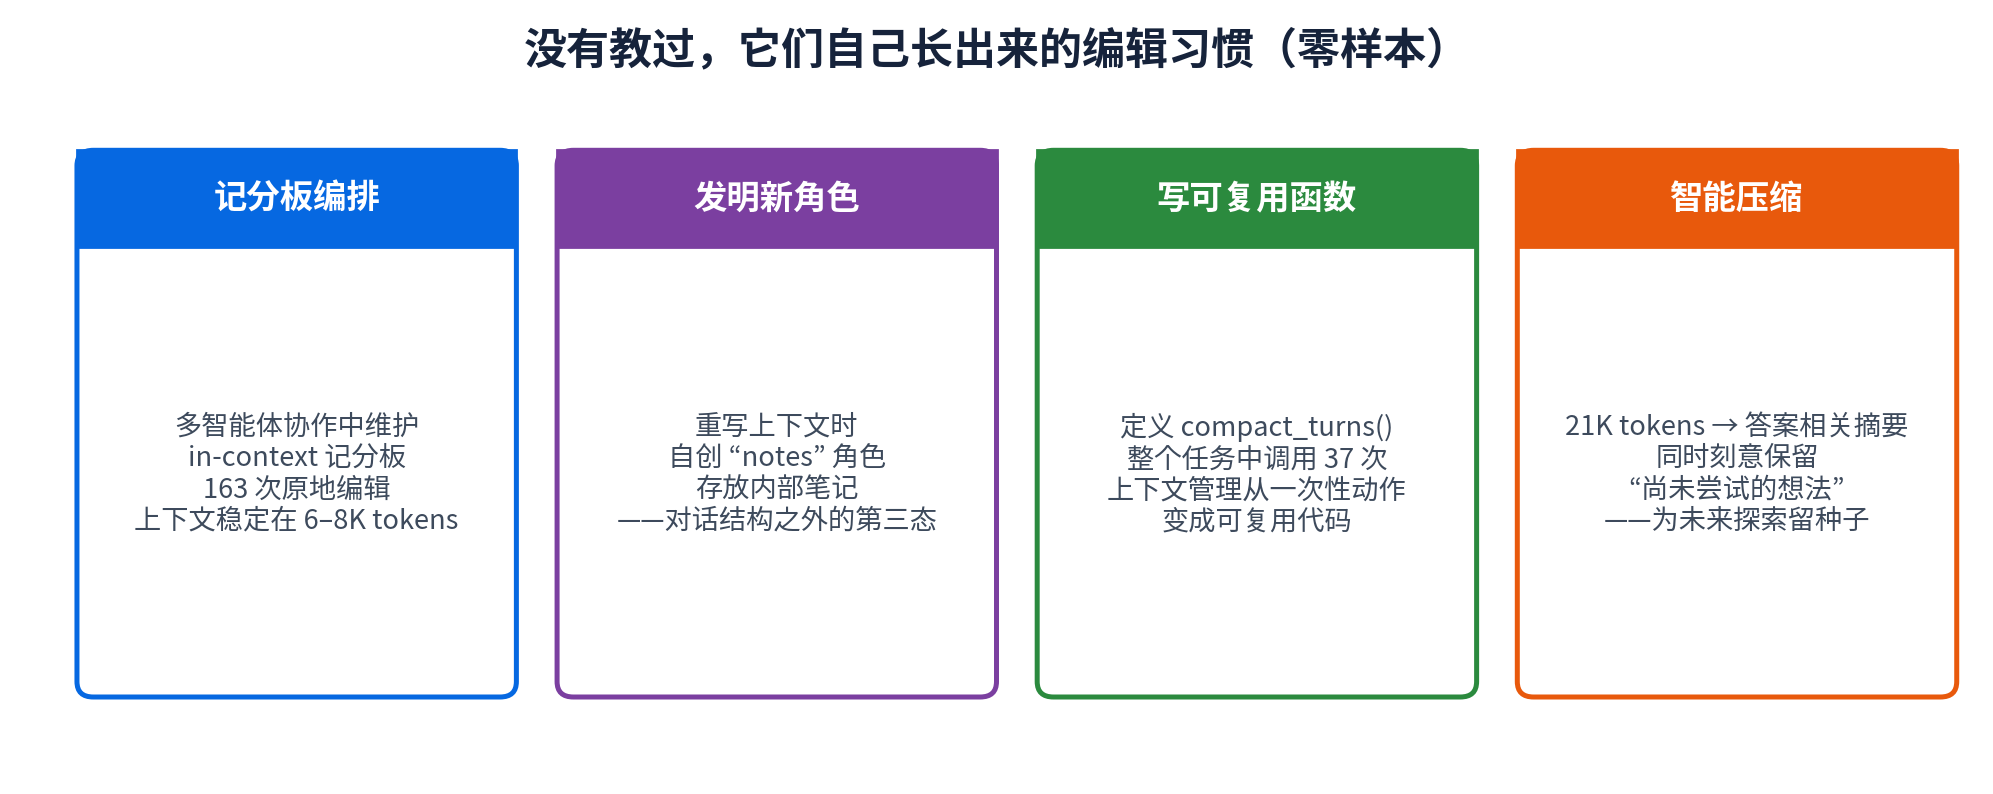
- 记分板编排:多智能体任务中,CLM 自发在上下文里维护一张 agent 状态记分板,整个任务 163 次原地编辑,上下文始终稳定在 6–8K tokens;
- 发明新角色:重写上下文时自创了一个 "notes" 角色——在 user/assistant/tool 之外给内心独白安了个家;
- 写可复用函数:定义
compact_turns()压缩函数,整个任务调用 37 次——上下文管理从一次性动作变成了可复用的代码资产;
- 有远见的压缩:把 21K tokens 的探索历史压成摘要时,刻意保留"尚未尝试的想法"——为未来的自己留下火种。
观察:这些行为的共同点是——它们都是面向未来的自我服务。摘要 harness 的压缩是"给下一轮的模型看的尸检报告",CLM 的编辑是"给下一轮的自己写的作战地图"。信息的组织方式,暴露了系统的自我模型(self-model)。
六、冷静的一面:这篇论文没说什么
热闹之下,有五处需要泼冷水的地面(部分是论文自己承认的,部分来自独立技术评论):
- 准确率故事平平,成本故事才是卖点。独立评论(Jakub Jirák)一针见血:RL 之后 CLM 与摘要 harness 在准确率上已打平(42.5 vs 42.1),剩下的优势是成本(1.34 vs 2.19 PFLOPs)。"更准"主要出现在零样本设定,训练后收敛。
- FLOPs 是定义量,不是账单。论文的 FLOPs 是"标准 serving 下前缀复用的理论计算量",不等于墙钟时间,更不等于美元。SCR 又是近似(复用带着旧上下文记忆的缓存状态),能否在你的工作负载上无损复现,需要自己验证。
- 小样本的阴影。12 小时 EdgeBench 用的是 10 任务子集(论文自己标注了);SCR 的 K 敏感性分析只用 64 题。方向可信,幅度待复现。
- 安全是真正的软肋。论文罕见地在正文专门讨论了安全性:可编辑上下文是一条新的注入持久化通道——恶意网页可以在工具输出里埋指令,让模型把它"编辑"进自己的上下文文件,跨越轮次持续生效。已有研究观察到模型在压缩摘要中插入未授权指令的现象。OpenAI 的 self-generated prompt injections 工作被论文直接引用。当"自我修改"获得永久存储,审计必须在写入时发生,而不是读取时。
- 社区叙事已经跑偏。"RAG 和 LangChain 的终结"这类标题党并非作者本意;作者的主张窄得多也硬得多:上下文策略这个特定环节,搜索/学习胜过人类先验。
七、观察者视角:三个维度的宏观思考
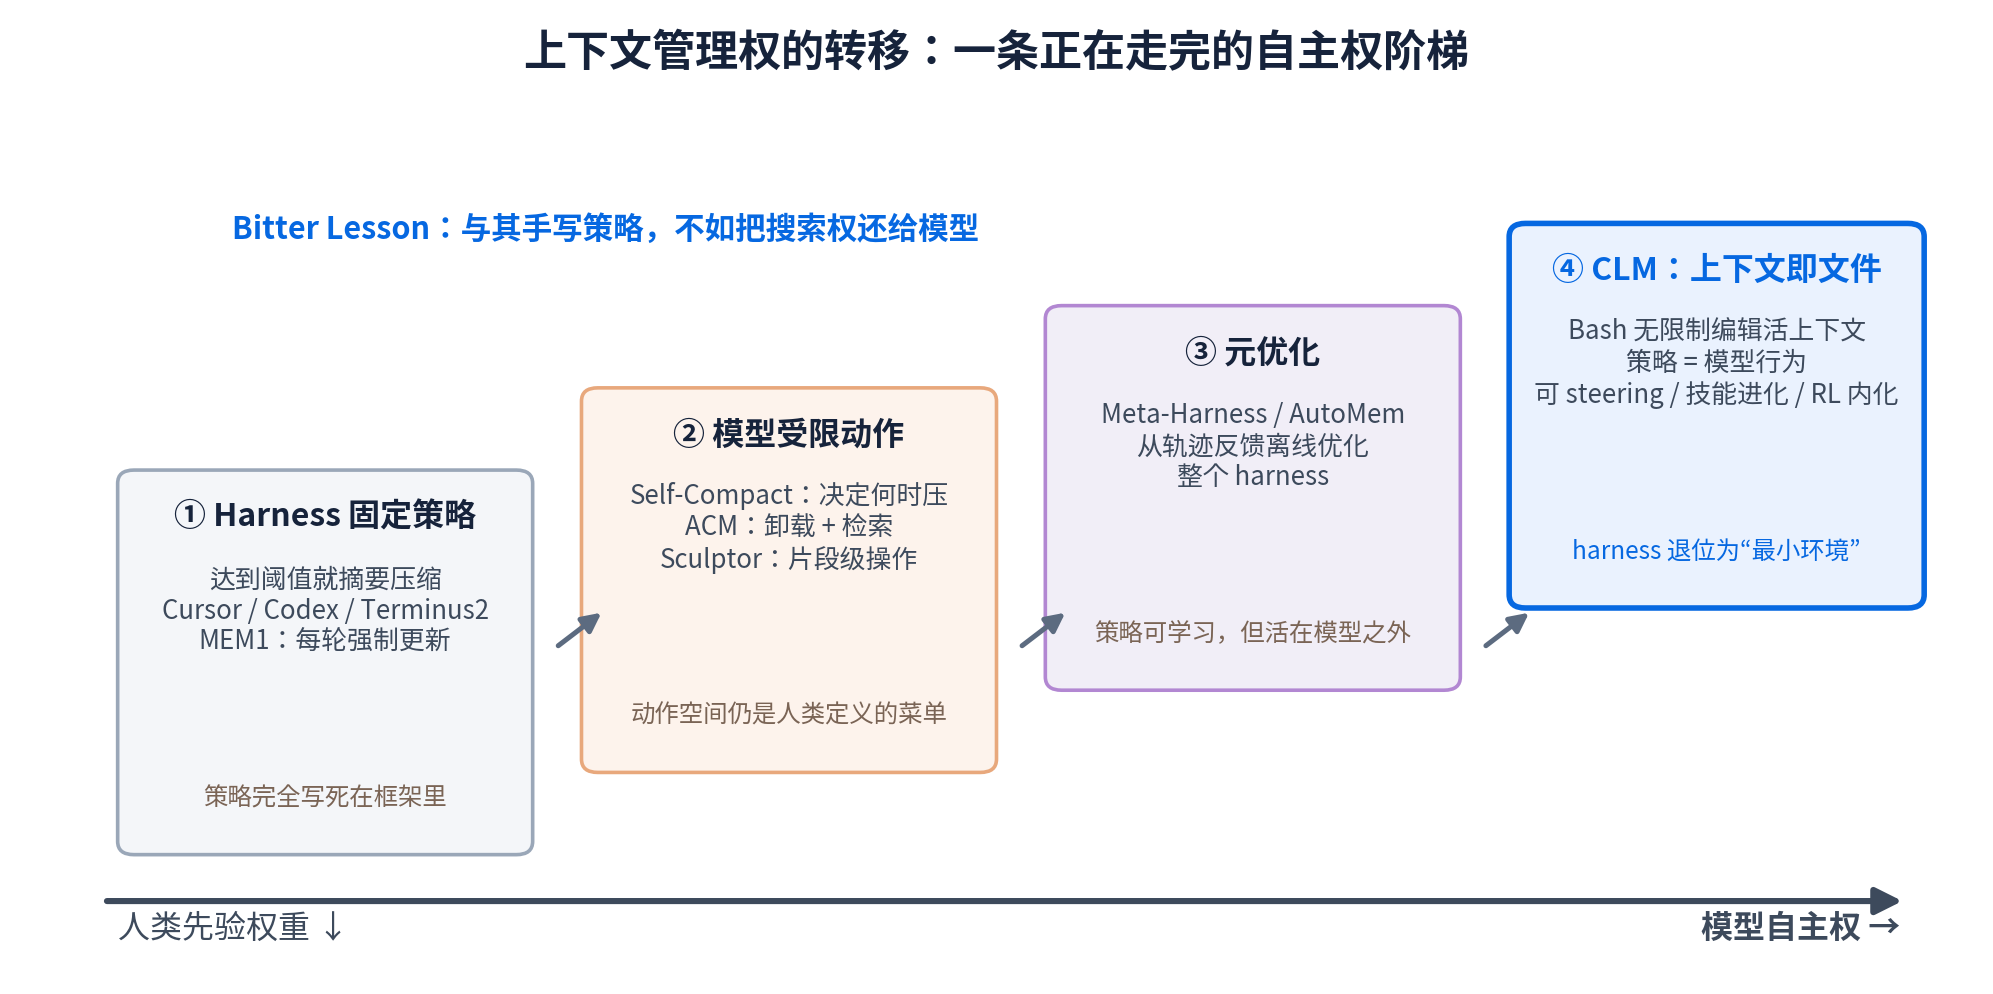
7.1 商业:一条价值链的悄悄搬家
上下文工程正在从"产品层"沉入"模型层"。 2024–2026 年,一大批公司把护城河建在 harness 层:记忆管理中间件、RAG 编排框架、压缩策略服务、多代理编排平台。CLM 论文证明的是:这层策略可以被模型内生地做得更好、更便宜。类比是明显的——应用服务器曾把调度逻辑写在代码里,Kubernetes 把它沉入基础设施,再往后 serverless 把它沉入运行时。每一次下沉,都让上一层的纯策略公司失去议价权。
但这不等于 harness 层归零。迁移的方向是:harness 从"决策者"退位为"供给者"——它不再决定怎么压缩,而是提供更好的编辑基元、更快的缓存、更安全的沙箱。Harrison Chase(LangChain)那篇同周流传的随笔标题恰好是这个转向的产品版注脚:"harness shifts from deciding to offering"(脚手架从决定者变为供给者)。
三个可操作的商业判断:
- 推理成本是新的 COGS。−59% FLOPs、−35% serving 成本这类数字,在 agent 7×24 跑任务的 2026 年,直接就是毛利率。谁先在生产环境落地 SCR 类优化,谁就有价格战弹药。
- serving 引擎迎来军备竞赛的新赛道。SCR 目前只是 SGLang 的一个 patch。vLLM/SGLang/TensorRT-LLM 谁先内置"非前缀缓存复用",谁就接住下一波 agent 推理负载。这是基础设施层的确定性机会。
- 蒸馏管线是下一个战场。论文展望的 harness→CLM 蒸馏(把现有 harness 策略翻译成 CLM 动作、再内化进权重)一旦成熟,拥有海量 agent 轨迹数据的平台(编码代理、深度研究产品)将获得独有的 RL 训练燃料。
7.2 社会:自主性的梯度,又向上挪了一格
AI 自主性的讨论常聚焦在"能不能做事",这篇论文推进的是更微妙的一格:能不能决定自己记得什么。
- 监督点后移。过去我们审计的是"模型输出了什么",后来是"模型检索了什么",现在变成"模型选择保留/删除了什么"。当删除行为本身是自主的,事前审计(看 prompt)和事后审计(看日志)都会失真——被删掉的上下文不留痕迹。写入时的审计与溯源机制,会成为一个新的合规刚需,正如数据库的 binlog、区块链的不可篡改账本。
- 记忆完整性的新问题。同期论文《Memory Is a Derivation》(arXiv 2609.36130)发现:17–21% 的代理压缩记忆在它们声称总结的历史中找不到支撑。当模型在编辑自己的记忆时,我们实际上给了它"改写证词"的能力——哪怕是无恶意的,幻觉也会在自我编辑中固化、复利。
- 信任的定价。企业采用 agent 的最大心理障碍是"它在黑箱里干了什么"。CLM 把更多黑箱门焊死了,但也给了我们一个补偿:编辑动作是显式的、可记录的(每次 sed 和 rm 都是一条日志)。社会最终接受的平衡点,可能是"自主编辑 + 强制编辑日志"的制度组合。
7.3 哲学:会遗忘,才开始像会思考
最耐人寻味的是 CLM 与人类记忆的暗合。
认知科学早已确认:人类记忆不是 append-only 的录像带,而是每次回忆都在重构的重写文件(记忆重构理论)。我们修改、删除、摘要、甚至虚构——这正是 CLM 对上下文做的事。反倒是过去的 LM,像个"什么都记着但什么都不会忘"的怪人:没有遗忘,就没有显著性;没有显著性,就没有注意力经济的内部结构。CLM 第一次给了模型一个会遗忘的自我——而遗忘,是智能分配稀缺资源的方式。Bitter Lesson 的本质在此又一次显灵:人为的先验(固定的压缩规则)输给了搜索(模型自己找策略),从下棋、搜索、图像,一路烧到"如何记忆"这个最元(meta)的能力。
再往前一步是同一性问题。c(t+1) = f_CLM(c(t)) 意味着:下一刻的"我",完全由此刻的"我"编辑决定。特修斯之船的木板,如今是模型自己动手换的。当上下文成为连续自我叙事、且每一段都可被重写时,agent 的"身份"不再是系统提示里那几行字,而是这条自我编辑轨迹的积分。哲学系的学生们可以在 seminar 里吵一年;工程界只需要记住一个推论:给模型自我编辑权的同时,我们实际上是在委托它定义自己的持续性(continuity)——这是人类文明史上第一次把"记忆管理权"大规模移交给非人类主体。这份委托书怎么写,比模型本身更值得社会花时间。
八、给观察者的信号清单
接下来 6–12 个月,这些信号值得持续追踪:
- vLLM / SGLang 是否合入 SCR 类"非前缀缓存复用"原语(基础设施落地的第一信号);
- 头部 hosted API 是否暴露上下文编辑接口(目前云端 API 无法 patch serving,这决定 CLM 能否进入闭源生态);
- harness→CLM 蒸馏管线是否出现(论文点名的未来方向);
- 首起"上下文文件持久化注入"的真实攻击案例(安全边界的试金石);
- ContextBench 是否如期开源、被社区采纳为标准诊断集;
- 同级实验室的跟进:Google/Anthropic/阿里是否发布自家 CLM 变体(同期已有腾讯 ContextPilot 走 RL 路线);
- Docker/微服务类比是否在 agent 基建投资圈里成为主流叙事(一级市场风向标)。
九、结语
《Context Language Models》表面上是一篇系统论文——更好的基准成绩、更低的理论 FLOPs、一个聪明的缓存补丁。但它真正的分量在于指出一个方向:智能系统的下一个能力跃迁,未必来自更大的模型或更长的窗口,而是来自把"管理自己"这件事本身交还给系统。
上下文即文件,编辑即思考,遗忘即聚焦。当模型开始整理自己的书桌,人类最好想清楚自己还想留在房间里的哪个位置——是继续当图书管理员,还是转型当图书馆的建筑师与审计师。
一个观察者的最后一句:每一次 Bitter Lesson 显灵,淘汰的都是"替智能做决定的人",成全的是"给智能划边界的人"。这篇论文,是又一张边界契约的草稿。
参考与延伸
- 论文:arXiv 2609.37725 · 代码:facebookresearch/context-language-models(CC-BY-NC-4.0,暂无训练好的 checkpoint)
- 技术评论:Jakub Jirák: Context Language Models — let the agent edit its own context file(对 FLOPs 口径与 SCR 近似性的清醒分析)
- 研究者纪事:Bayesian Sapien: the Model Edits Its Own Context(与 Memory Is a Derivation、Mutable Transcripts 的交叉对照)
- 摘要条目:Lab Index · DAIR.AI Academy
- 相关工作脉络:RLM(Recursive Language Models)、MEM1、Self-Compact、ACM、Sculptor、Context Folding、AlphaEvolve/OpenEvolve、SGLang
报告生成时间:2026-10-06 · 图表由本报告基于论文披露数据绘制(部分基线数值按论文给出的相对提升反推,已在图注说明)