Tabero:让机器人学会「轻拿轻放」的触觉—力反馈基准与模型
现有 VLA 模型没有触觉、也不会闭环用力,机器人「手太重」——抓碎薯片、捏瘪易拉罐。Tabero 把开源轨迹重放进高保真触觉仿真,第一次把「下手轻重」变成可复现的数字,并给出力—位解耦的解法。
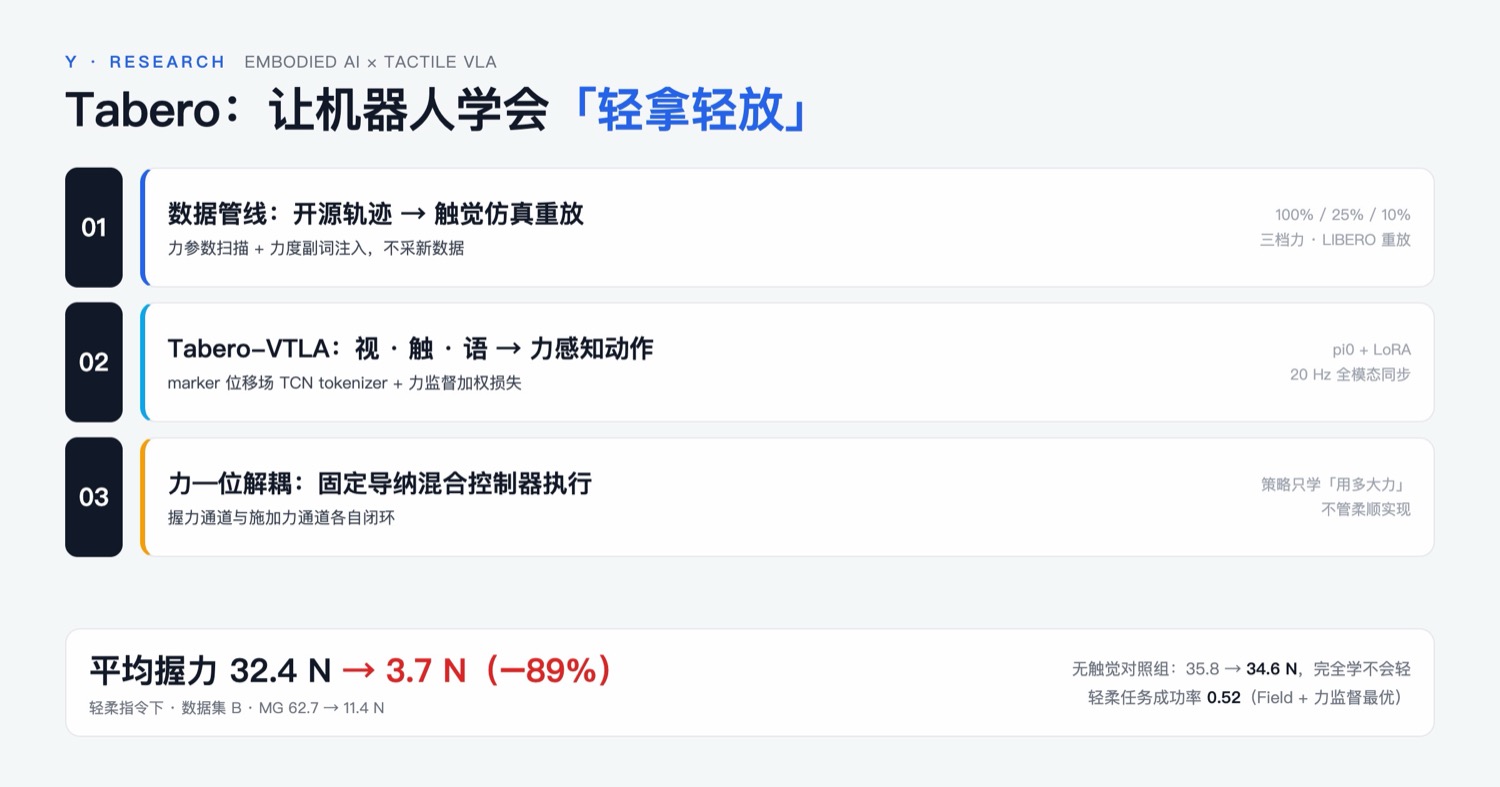
- 论文:Tabero: Learning Gentle Manipulation with Closed-Loop Force Feedback from Vision, Touch, and Language
- arXiv:2605.27886 · cs.RO · 2026-05-27 · 代码:github.com/NathanWu7/Tabero
- 作者:Qiwei Wu 等(港科大(广州)× NVIDIA 北京)
分类
- 类别:
benchmark(主)×multimodal(辅)—— 触觉-视觉-语言-动作(VTLA)评测基准 + 模型套件
- 置信度:0.9。双核心:一是标准化触觉操作 benchmark,二是多模态(视觉-触觉-语言)力感知模型
- 理由:论文同时贡献「数据生成管线 + 评测协议」与「力感知 VTLA 架构」,属于具身多模态方向
一句话总结
Tabero 把开源机器人轨迹「重放」进高保真触觉仿真,造出第一个能同时量化「任务成败」与「下手轻重」的视觉-触觉-语言基准,并配套提出力-位解耦的 VTLA 模型——在「轻拿轻放」指令下平均握力降低 70%+ 而成功率几乎不掉。
按 Benchmark 阅读指南五问
1. 属于哪个领域?解决什么问题?
机器人操作(Robot Manipulation)× 具身智能。核心问题:现有 VLA(Vision-Language-Action)模型没有触觉模态,也不会闭环用力——机器人「手太重」,抓碎薯片、捏瘪易拉罐。两个根因:
- 视觉-触觉-语言对齐数据极度稀缺(自建触觉硬件成本高、采集效率低);
- 缺乏过程级评测:只看成功率 SR,不问「过程中用了多大力、有没有捏坏物体」。
2. 数据规模、评测环境与样例
- 环境:Isaac Lab(Isaac Sim)+ TacEx/Taxim/FOTS 触觉仿真,模拟 GelSight 传感器(320×240 RGB 触觉图 + 11×9 marker 网格),双目相机(腕部 + 第三人称)RGB-D,全模态 20 Hz 同步。
- 数据来源:把 LIBERO 等开源 MuJoCo 轨迹重放进 Isaac,替换为带触觉的 Franka 夹爪;通过改变夹爪阻抗参数
Kp ∈ {2000, 500, 200}N/m、Kd ∈ {100, 25, 10}N·s/m 制造 100%/25%/10% 三档力,并注入副词(firmly/tightly ↔ gently/softly,随机插入句首句尾)。
- 评测子集:LIBERO Object 的 9 个任务 × 两种力度副词;数据集 A(25% 力连续控制)、B(10% 力连续控制,极易打滑)、C(10% 力但离散开关指令,用于无触觉消融)。
- 任务样例:"gently pick up the alphabet soup and place it in the basket"(轻柔地把意面汤罐头放进篮子)。
3. 有哪些同类 benchmark?差异与优势?
| 对比项 | LIBERO / RoboCasa / CALVIN / RoboTwin | 触觉仿真(Tacto/Taxim/TacSL/Taccel…) | Tabero |
|---|---|---|---|
| 视觉多样性 | ✅ | ❌(单传感器验证为主) | ✅ |
| 触觉信号 | ❌ | ✅ | ✅ 大规模、多任务 |
| 语言条件 | 部分 | ❌ | ✅ 力度副词标注 |
| 轻柔度指标 | ❌ | ❌ | ✅ MG/AG/MA/AA |
优势:首个把「可扩展视-触-语数据生成」与「交互轻柔度标准化度量」合在一处的 benchmark;且数据管线复用开源轨迹,不需要重采数据。
4. 评估方法与主要结果
过程级四指标:MG(峰值握力,top-5% 均值)、AG(接触期平均握力)、MA/AA(施加力峰值/均值)。
- 跨平台保真:同构重放 SR 0.85→0.76,接近原版;换触觉夹爪后 100% 力下 0.60,10% 力下仅 0.36——细力度任务对末端执行器与力控极敏感。
- 力调制能力(数据集 B,训练时按 10% 力执行):轻柔指令下 AG 32.4 N → 3.7 N(降 89%),MG 62.7 → 11.4 N;成功率 0.86 → 0.52(超轻柔档天然难)。无触觉的 C 组:AG 35.8 → 34.6 N,完全学不会轻。
- 消融:无触觉输入 SR=0 全崩;只给触觉 token(Img/Field/Force)SR≈0.37–0.40;加力监督(FS)后轻柔 SR 跳到 0.31–0.52;Field+FS 最优(轻柔 SR 0.52、AG 3.7 N)。
- 控制器消融:去掉前馈项或导纳项,25% 力跟踪曲线明显劣化(超调/打滑)。
- 语义-力泛化:训练只见过 firmly/gently,OOD 副词 lightly/forcefully 下模型给出中间力度(AG 14.5/18.1 N,介于 3.7 与 32.4 之间),显示零样本的「语义→力度」组合泛化,但成功率下降(0.61/0.64)。
5. 是否提出了新模型?创新点何在?
Tabero-VTLA(基于 pi0/PaliGemma + flow matching,LoRA 微调):
- 三种触觉注入方案对比:marker 位移场→TCN tokenizer(默认,硬件无关,兼容压电/电容/磁阻/视触觉);触觉图像→复用 VIT 走 cross-attention;6D 指尖力→MLP(编码器前缀注入 / 解码器后缀注入)。
- 力监督加权损失:flow matching 损失中对力维度加权
λ_force,公式L = (1/D_act) · Σ_d w_d(e_d)²。
- 力-位解耦的分层命令接口:高层策略只输出「位姿 + 目标力」chunk,执行交给固定的导纳混合控制器——握力通道(前馈
(1+k_ff)·F_grip^pred+ 导纳修正 + 死区)与施加力通道(导纳位置修正 + 差分 IK)分开闭环。策略不实现柔顺,只学会「该用多大力」。
多模态指南补充
- 模态对齐:触觉不进语言空间,而是作为条件 token 前缀注入 transformer;触觉图像则复用视觉编码器做特征级交互。
- 训练策略:pi0 基座 + LoRA;action_dim 32(有效 13),触觉历史 8 帧;peak LR 2.5e-5,5 万步,batch 32。
- 效率与部署:力反馈在低层控制回路(快速环)实时执行,VLA 高层(慢速环)只出 chunk 命令,天然解耦推理频率与控制频率。
创新点
- 首个轻柔度标准化评测协议(MG/AG/MA/AA),把「温柔」变成可复现的数字。
- 数据复用经济学:不采新数据,用仿真重放 + 力参数扫描 + 副词注入,批量制造「同一任务、不同力度、语言对齐」的多模态数据。
- 力-位解耦接口:让 VLA 学「力意图」、让固定控制器管「力执行」,回避了端到端力控的不稳定。
局限性
- 纯仿真验证,触觉保真度与执行器动力学的 sim-to-real 差距未测;
- 未联合优化成功率与最小力——超轻柔档(10% 力)成功率骤降,温柔与可靠存在内在 trade-off;
- 语言力度词只覆盖英文副词,语义-力映射的泛化仍有限(OOD 副词成功率下降)。
附录补充
- 附录 A/B:完整超参(TCN 输入 11×9×2×(H+1),MLP 输入 8×6=48;控制器 Grip.ff.k=0.6、Grip.kp=8e-4、死区 0.25、力滤波 α=0.2)。
- 附录 C:副词随机注入句首/句尾共 8 种组合的任务模板;Tabero 子集 9 个抓放任务清单。
- 附录 D:全部 40 个任务 × 3 档力的数据保留率表(100% 力下 Object 套件 82–96%,10% 力下大量任务掉到 6–46%,印证超轻柔档难度)。
- 附录 E:Image-based 与 Force-based VTLA 的泛化测试与 Table 4 趋势一致。
参考
- arXiv:2605.27886 — Tabero: Learning Gentle Manipulation with Closed-Loop Force Feedback from Vision, Touch, and Language ↗